STATISTICA SOCIALE
1. 📊 MEDIA ARITMETICA
🎬 Cosa significa?
La media serve a trovare il valore che rappresenta, in modo sintetico, un insieme di dati.
Immagina 5 studenti con questi voti:
18, 20, 24, 26, 30
Vogliamo sapere qual è il voto medio.
Sommiamo tutti i voti e dividiamo per il numero degli studenti.
📌 Formula
xˉ=∑xi / N
Non spaventarti dalla formula. Significa semplicemente:
media = somma di tutti i valori ÷ numero dei valori
🔍 Simbolo per simbolo
| Simbolo | Significato |
|---|---|
| xˉ | media |
| ∑ | sommatoria, cioè "somma tutto" |
| xi | ogni singolo valore |
| N | numero totale dei valori |
🔢 Esempio
Dati:
18, 20, 24, 26, 30
Sommiamo:
18+20+24+26+30=118
Abbiamo 5 valori:
N=5
Quindi:
xˉ=1185
xˉ=23,6
La media è 23,6.
🧠 Trucco
Ricorda:
MEDIA = SOMMA ÷ NUMERO
Quando vedi:
xˉ
pensa immediatamente:
"Devo sommare e dividere."
⚠️ Errore tipico
Non devi dividere per il valore più grande.
❌ 118 ÷ 30
✅ 118 ÷ 5
2. 📏 VARIANZA
Questa è più difficile, ma è fondamentale.
🎬 Cosa significa?
La media ci dice dove si trova il centro.
La varianza ci dice:
quanto i dati sono sparsi intorno alla media.
Confrontiamo:
Gruppo A
4, 5, 5, 5, 6
I valori sono vicini alla media.
Gruppo B
1, 2, 5, 8, 9
I valori sono molto più sparsi.
Le due serie possono avere una media simile, ma la seconda ha una maggiore variabilità.
La varianza serve proprio a misurare questa dispersione.
📌 Formula
σ2=∑(xi−xˉ)2N
Questa formula va letta come una sequenza:
1. Trova la media
↓
2. Calcola quanto ogni valore si discosta dalla media
↓
3. Eleva gli scarti al quadrato
↓
4. Somma
↓
5. Dividi per N
🔍 Simbolo per simbolo
| Simbolo | Significato |
|---|---|
| σ2 | varianza |
| xi | singolo valore |
| xˉ | media |
| xi−xˉ | distanza dalla media |
| (xi−xˉ)2 | distanza al quadrato |
| ∑ | somma |
| N | numero dei dati |
🔢 Esempio completo
Prendiamo:
2, 4, 6
Passo 1 — Media
xˉ=2+4+63=4
Passo 2 — Scarti dalla media
| Valore | Media | Scarto |
|---|---|---|
| 2 | 4 | -2 |
| 4 | 4 | 0 |
| 6 | 4 | +2 |
Passo 3 — Eleviamo al quadrato
(−2)2=4
02=0
22=4
Quindi:
4, 0, 4
Passo 4 — Sommiamo
4+0+4=8
Passo 5 — Dividiamo per N
σ2=83
σ2=2,67
🧠 Trucco
Memorizza questa frase:
SCARTO → QUADRATO → SOMMA → DIVIDI
È praticamente tutta la formula.
⚠️ Attenzione
Se stai lavorando su un campione, spesso la formula diventa:
s2=∑(xi−xˉ)2n−1
Quindi devi capire dal testo dell'esercizio se hai:
popolazione → N
campione → n−1
3. 📐 DEVIAZIONE STANDARD
🎬 Cosa significa?
La deviazione standard è strettamente collegata alla varianza.
La varianza ha un problema: viene espressa in unità al quadrato.
Per esempio, se stiamo misurando anni, la varianza sarebbe in:
anni2
Non è molto intuitivo.
Facciamo quindi la radice quadrata.
📌 Formula
σ=σ2
Quindi:
deviazione standard = radice quadrata della varianza
🔢 Esempio
Abbiamo trovato:
σ2=2,67
Facciamo la radice:
σ=2,67
σ≈1,63
🧠 Interpretazione
Se abbiamo:
xˉ=4
e:
σ=1,63
significa, in maniera intuitiva, che i dati presentano una dispersione attorno alla media dell'ordine di circa 1,63 unità.
🧠 Trucco
Ricorda:
VARIANZA = quadrato
DEVIAZIONE STANDARD = radice
Infatti:
σ2→ →σ
4. 📊 COEFFICIENTE DI VARIAZIONE
Questa formula serve soprattutto per confrontare la variabilità relativa.
🎬 Cosa significa?
Immagina due gruppi.
Gruppo A
Media = 10
Deviazione standard = 2
Gruppo B
Media = 100
Deviazione standard = 10
A prima vista il gruppo B ha una deviazione standard maggiore:
10>2
Ma è davvero più variabile?
Non necessariamente.
Per confrontarli utilizziamo il coefficiente di variazione.
📌 Formula
CV=σxˉ×100
In pratica:
deviazione standard ÷ media × 100
🔢 Esempio
Media:
xˉ=50
Deviazione standard:
σ=5
Quindi:
CV=550×100
CV=0,1×100
CV=10%
🧠 Interpretazione
Un CV del 10% significa che la deviazione standard rappresenta circa il 10% della media.
Più alto è il CV, maggiore è la variabilità relativa.
🧠 Trucco
Pensa:
CV = quanto è grande la deviazione rispetto alla media?
Quindi:
CV=DISPERSIONECENTRO×100
5. 📏 INTERVALLO INTERQUARTILE
🎬 Cosa significa?
Immagina di ordinare tutti i dati dal più piccolo al più grande.
Li dividiamo idealmente in quattro parti.
25%25%25%25%
I punti importanti sono:
Q1, Q2, Q3
dove:
Q1 = 25° percentile
Q2 = 50° percentile = mediana
Q3 = 75° percentile
L'intervallo interquartile misura la distanza tra Q1 e Q3.
📌 Formula
IQR=Q3−Q1
🔢 Esempio
Supponiamo:
Q1=20
Q3=35
Allora:
IQR=35−20
IQR=15
Quindi il 50% centrale dei dati è contenuto in un intervallo di ampiezza 15.
🧠 Perché è utile?
È meno influenzato dai valori estremi rispetto alla deviazione standard.
Per esempio, se una persona guadagna:
1.500€
e un'altra:
1.000.000€
quel valore enorme può influenzare molto la media.
L'IQR guarda invece la parte centrale della distribuzione.
🧠 Trucco
IQR=Q3−Q1
Pensa:
"Dal terzo quartile tolgo il primo."
6. 🔗 CORRELAZIONE
Questa è una delle formule più importanti.
🎬 Cosa significa?
Abbiamo due variabili.
Per esempio:
X = ore di studio
Y = voto all'esame
Ci chiediamo:
Quando aumentano le ore di studio, tende ad aumentare anche il voto?
La correlazione misura direzione e intensità della relazione lineare.
📌 Formula
r=Cov(X,Y)σXσY
🔍 Simbolo per simbolo
| Simbolo | Significato |
|---|---|
| r | coefficiente di correlazione |
| Cov(X,Y) | covarianza |
| σX | deviazione standard di X |
| σY | deviazione standard di Y |
🔢 Esempio
Supponiamo:
Cov(X,Y)=6
σX=2
σY=3
Allora:
r=62×3
r=66
r=1
Abbiamo una correlazione perfettamente positiva.
📊 Come interpretare r?
| r | Interpretazione |
|---|---|
| +1 | relazione positiva perfetta |
| +0,8 | forte positiva |
| +0,5 | positiva moderata |
| 0 | nessuna relazione lineare |
| −0,5 | negativa moderata |
| −0,8 | forte negativa |
| −1 | negativa perfetta |
🧠 Trucco
Ricorda:
Segno = direzione
+→insieme
−→opposti
Valore assoluto = forza
∣r∣→1
= relazione forte.
⚠️ ERRORE DA ESAME
Non dire:
"Se X e Y sono correlate, X causa Y."
❌ Sbagliato.
La correlazione non dimostra causalità.
7. 🎲 PROBABILITÀ CONDIZIONATA
Questa sembra difficile, ma il concetto è semplicissimo.
🎬 Cosa significa?
La parola fondamentale è:
SAPENDO CHE
Supponiamo di avere 100 studenti.
Vogliamo sapere:
Qual è la probabilità che uno studente superi l'esame sapendo che ha frequentato il corso?
Non consideriamo più tutti i 100 studenti.
Consideriamo solo quelli che hanno frequentato.
📌 Formula
P(A∣B)=P(A∩B)P(B)
Si legge:
probabilità di A dato B.
🔍 Simboli
A = evento che ci interessa
B = condizione che sappiamo essere vera
A∩B = A e B contemporaneamente
P(A∣B) = probabilità di A sapendo B
🔢 Esempio
Abbiamo 20 studenti.
12 hanno frequentato.
Tra questi 12:
8 hanno superato l'esame.
La domanda è:
Qual è la probabilità di superare l'esame sapendo che si è frequentato?
Il nostro nuovo universo è:
12
Tra questi, i favorevoli sono:
8
Quindi:
P(Superato∣Frequentato)=812
=0,667
ovvero:
66,7%
🧠 TRUCCO FONDAMENTALE
Quando vedi:
P(A∣B)
pensa:
"DATO B, guardo solo B."
Quindi il denominatore sarà legato a B.
8. 🧮 CHI-QUADRATO χ2
Questa è probabilmente la formula che richiede più attenzione.
🎬 Cosa significa?
Supponiamo di voler capire se esiste una relazione tra:
genere
preferenza politica
Abbiamo una tabella:
| A | B | Totale | |
|---|---|---|---|
| Gruppo 1 | 30 | 20 | 50 |
| Gruppo 2 | 20 | 30 | 50 |
| Totale | 50 | 50 | 100 |
La domanda è:
Le differenze che vediamo sono sufficientemente grandi da suggerire un'associazione tra le variabili?
Il chi-quadrato confronta:
ciò che abbiamo osservato
con
ciò che ci aspetteremmo se non ci fosse associazione.
📌 Formula
χ2=∑(O−E)2E
🔍 Simboli
| Simbolo | Significato |
|---|---|
| O | frequenza osservata |
| E | frequenza attesa |
| ∑ | somma di tutte le celle |
🔢 Come troviamo la frequenza attesa?
Formula:
E=Totale riga×Totale colonnaTotale generale
Per la prima cella:
E=50×50100
E=25
Quindi:
osservato = 30
atteso = 25
Ora:
(30−25)225
=2525
=1
Facciamo la stessa cosa per tutte le celle e sommiamo.
🧠 Il significato profondo
Se:
O≈E
le differenze sono piccole.
Quindi:
χ2
sarà relativamente piccolo.
Se invece:
O≫E
o:
O≪E
le differenze sono grandi.
Quindi:
χ2
aumenta.
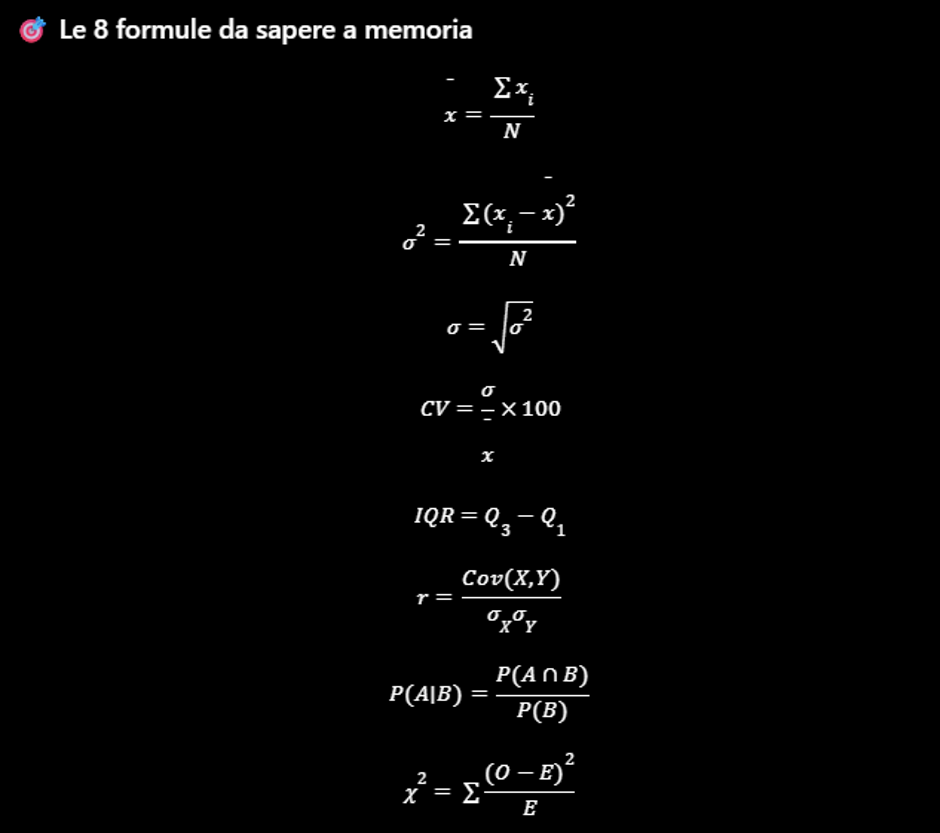
🧠 LE 8 FORMULE IN UNA SOLA MAPPA
Ora prova a non guardarle come 8 formule separate.
Pensale come una storia:
1️⃣ Voglio trovare il centro
xˉ=∑xiN
MEDIA
↓
2️⃣ Voglio sapere quanto sono sparsi i dati
σ2=∑(xi−xˉ)2N
VARIANZA
↓
3️⃣ Voglio riportare la dispersione all'unità originale
σ=σ2
DEVIAZIONE STANDARD
↓
4️⃣ Voglio confrontare la dispersione rispetto alla media
CV=σxˉ×100
COEFFICIENTE DI VARIAZIONE
↓
5️⃣ Voglio descrivere la parte centrale della distribuzione
IQR=Q3−Q1
INTERVALLO INTERQUARTILE
↓
6️⃣ Voglio capire se due variabili si muovono insieme
r=Cov(X,Y)σXσY
CORRELAZIONE
↓
7️⃣ Voglio calcolare una probabilità sapendo una condizione
P(A∣B)=P(A∩B)P(B)
PROBABILITÀ CONDIZIONATA
↓
8️⃣ Voglio verificare se due variabili categoriali sono associate
χ2=∑(O−E)2E
CHI-QUADRATO
🎯 LA COSA PIÙ IMPORTANTE DA IMPARARE
Non memorizzare solo le formule. Per l'esame devi riuscire a riconoscere quando usarle.
| Se l'esercizio chiede... | Devi pensare a... |
|---|---|
| "Qual è il valore medio?" | 📊 Media |
| "Quanto sono dispersi i dati?" | 📏 Varianza |
| "Qual è la dispersione nell'unità originale?" | 📐 Deviazione standard |
| "Quale gruppo è relativamente più variabile?" | 📊 CV |
| "Quanto è ampia la parte centrale?" | 📏 IQR |
| "Quanto sono associate X e Y?" | 🔗 Correlazione |
| "Qual è la probabilità sapendo che..." | 🎲 Probabilità condizionata |
| "C'è associazione tra due variabili categoriali?" | 🧮 Chi-quadrato |
La vera abilità all'esame è questa: leggere il testo dell'esercizio e capire quale formula scegliere prima ancora di iniziare a fare i calcoli.